이런 시장에서 역발상으로 승부를 거는 국내 AI 반도체 스타트업이 있다. 비싸고 수급이 어려운 HBM 대신 모바일용 저전력 메모리인 LPDDR을 쓰고, 수백~수천 개의 작은 연산 코어 대신 LLM 연산을 최대한 한 코어 안에서 처리하는 빅코어 아키텍처를 택한 하이퍼엑셀이다.
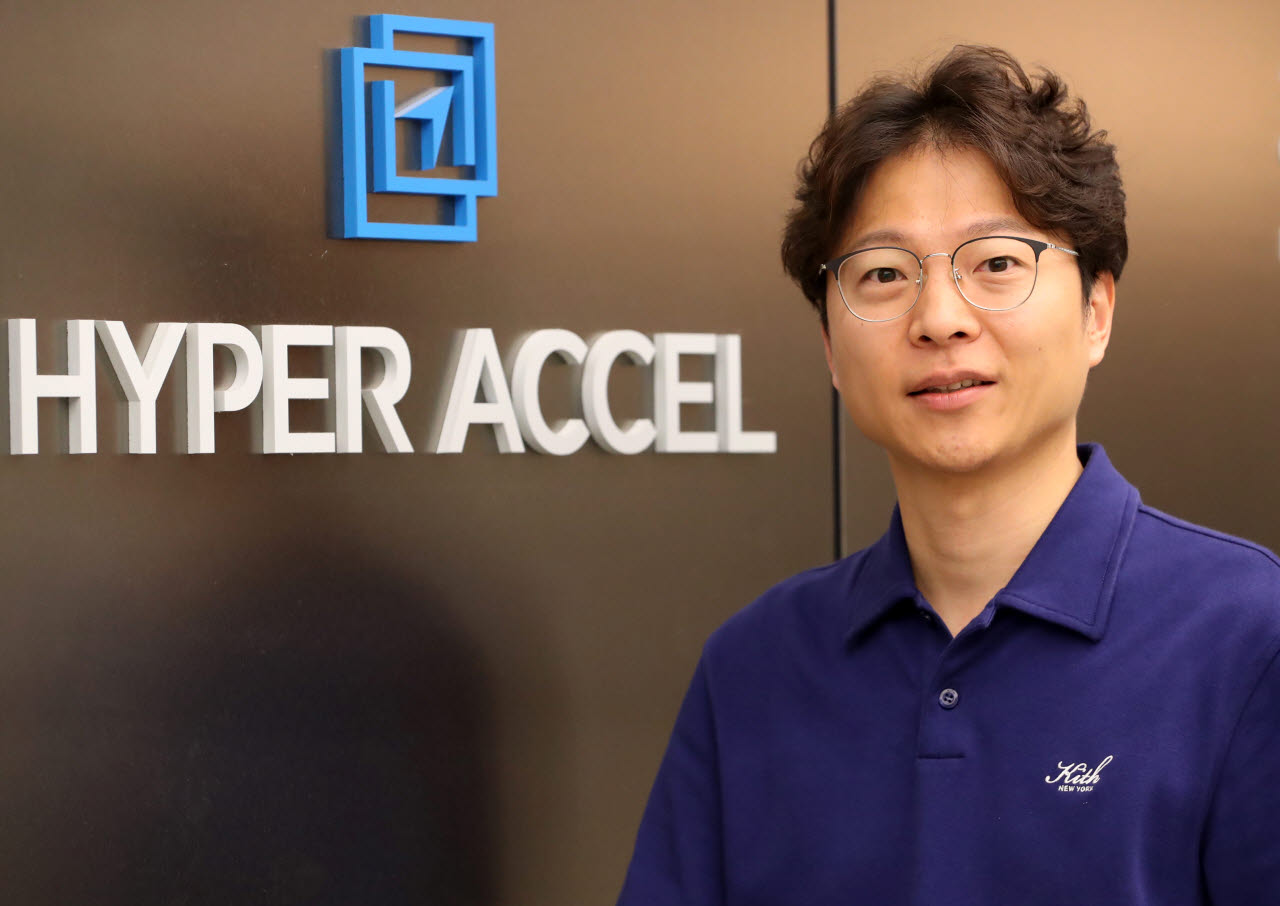
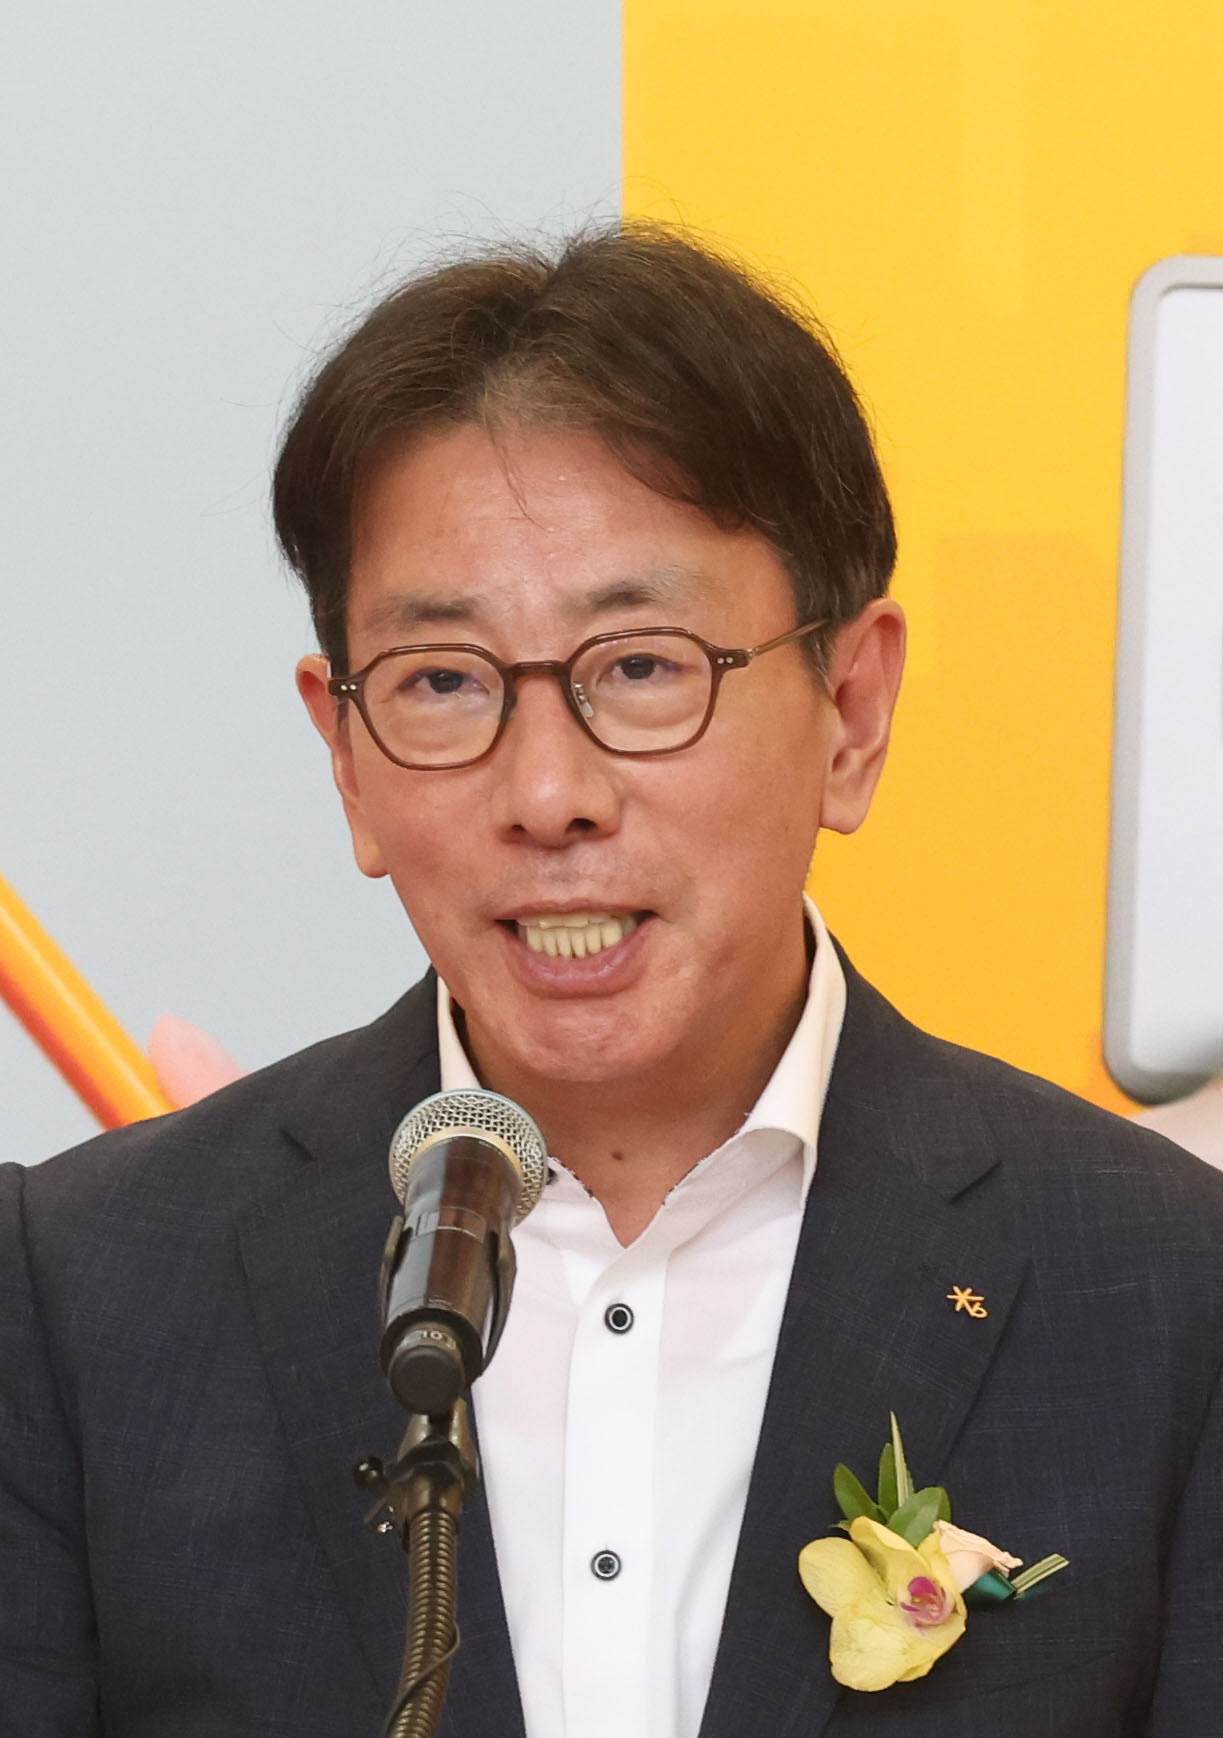
김주영 하이퍼엑셀 대표. [이데일리 김태형 기자]
최근 서울 강남구 하이퍼엑셀 본사에서 만난 김주영 대표(43)는 베르다 실물을 들어 보이며 “절대적인 피크 성능만 놓고 일대일로 맞붙으면 엔비디아 H200을 이길 수는 없다”고 말했다.
그러면서도 “같은 비용, 같은 전력으로 얼마나 많은 토큰을 만들어낼 수 있느냐(Per-Dollar, Per-Watt)로 기준을 바꾸면 판도가 달라진다”며 “HBM의 대척점에 있는 LPDDR을 선택했지만 칩 아키텍처 혁신을 통해 메모리 대역폭을 90% 이상 쥐어짰다. 실제 서비스 현장에서 바로 쓸 수 있는 가성비 혁명을 입증해 보이겠다”고 강조했다.
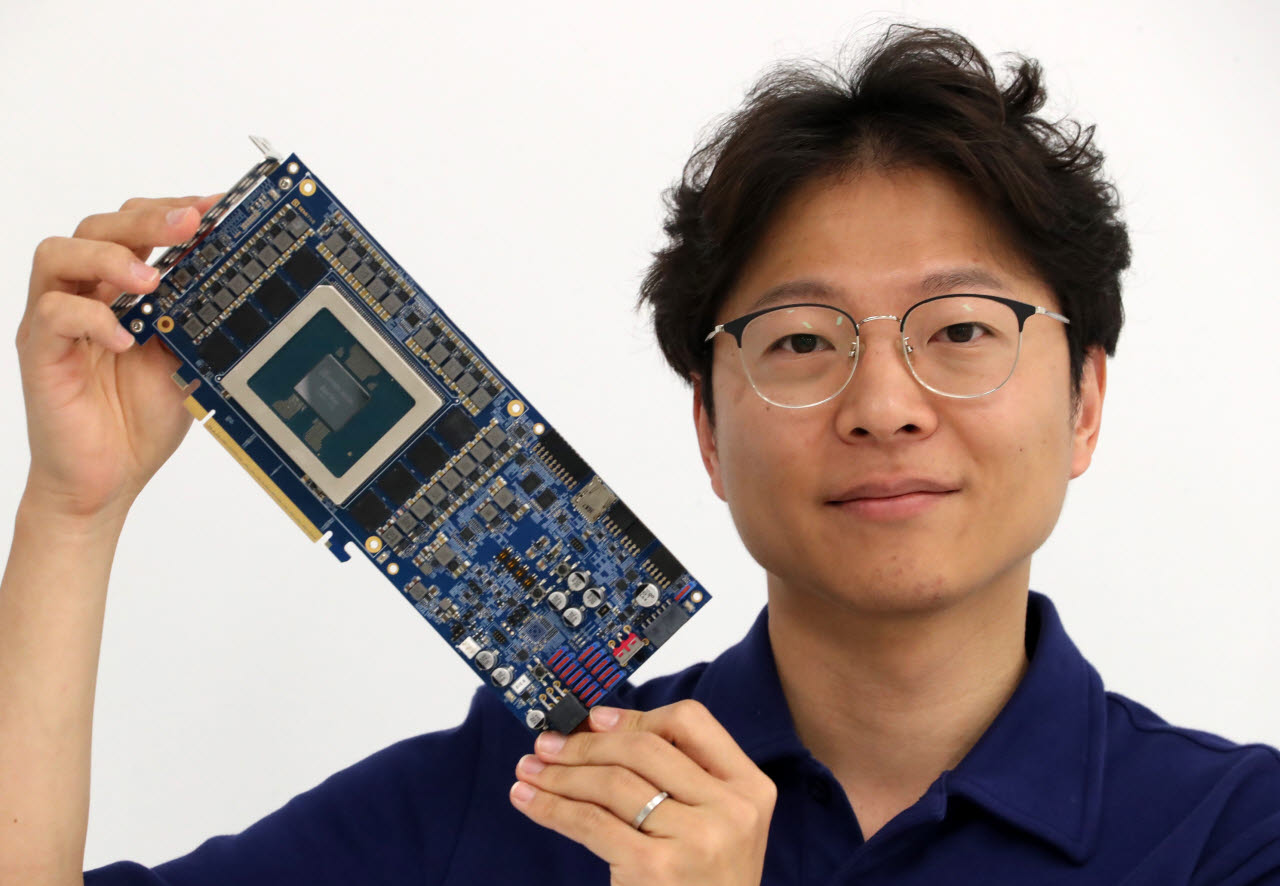
김주영 하이퍼엑셀 대표가 서버용 LPU ‘베르다(Verda)’를 들고 있다. [이데일리 김태형 기자]
하이퍼엑셀은 기존 NPU(신경망처리장치)의 구조적 한계에 주목했다.
기존 NPU는 합성곱신경망(CNN) 기반 딥러닝이나 이미지 처리에 적합하도록 작은 연산 코어를 수백 개, 수천 개씩 배열하는 방식이 일반적이다. 하지만 수십억~수천억 개의 파라미터를 가진 LLM에서는 코어 사이로 방대한 데이터가 오가면서 데이터 이동 자체가 병목이 될 수 있다는 게 김 대표의 설명이다.
“작은 코어들 사이의 데이터 이동 자체가 시스템 전체의 발목을 잡습니다. 하이퍼엑셀은 작은 코어를 수백 개 쓰는 대신 하나의 코어가 트랜스포머 연산 전 과정을 통째로 처리할 수 있도록 설계했습니다. 이런 빅코어를 수십 개 구성하는 방식입니다.”
골자는 연산을 코어 내부에서 최대한 끝내 데이터 이동을 줄이는 것이다. 하이퍼엑셀은 이를 ‘스트림라인 데이터플로우(Streamlined Dataflow)’ 아키텍처라고 부른다.
이 기술은 특허로도 권리화하고 있다. 하이퍼엑셀은 현재 국내외에서 총 74건의 특허를 출원·등록했거나 진행 중이며, 이 가운데 LPU와 LLM 추론 관련 기술에 대한 국내외 등록 특허를 다수 확보했다.
대표적인 것이 ‘레이턴시 프로세싱 유닛(Latency Processing Unit)’ 관련 특허다. 국내에서는 2023년 4월 출원해 같은 해 11월 등록했고, 미국에서도 2023년 12월 출원해 2024년 7월 등록을 마쳤다. 국내 등록번호는 10-2609481, 미국 등록번호는 12,032,925다.
이밖에도 LLM을 여러 장치에서 분산 처리하는 방법, 생성형 AI 모델을 하드웨어에 효율적으로 배치하는 방법, 가중치를 메모리에 매핑하는 방법 등으로 특허 포트폴리오를 넓혀가고 있다. LLM 연산의 정밀도를 검증하는 기술과 혼합정밀도 MAC 트리 구조도 국내와 미국에서 각각 특허 등록을 마쳤다.
하이퍼엑셀 관계자는 “LLM 추론을 위한 데이터 포워딩, 메모리 매핑, KV 캐시 압축, 이종 컴퓨팅 클러스터 등과 관련한 특허의 PCT와 미국·유럽·일본·중국 출원도 진행하고 있다”며 “지난 7월에도 연산 처리 장치, 데이터 접근 최적화, 행렬 연산 엔진, 벡터 연산 유닛, 메모리 주소 변환, PIM(Processing-In-Memory) 기능과 관련한 신규 특허를 추가 출원했다”고 설명했다.
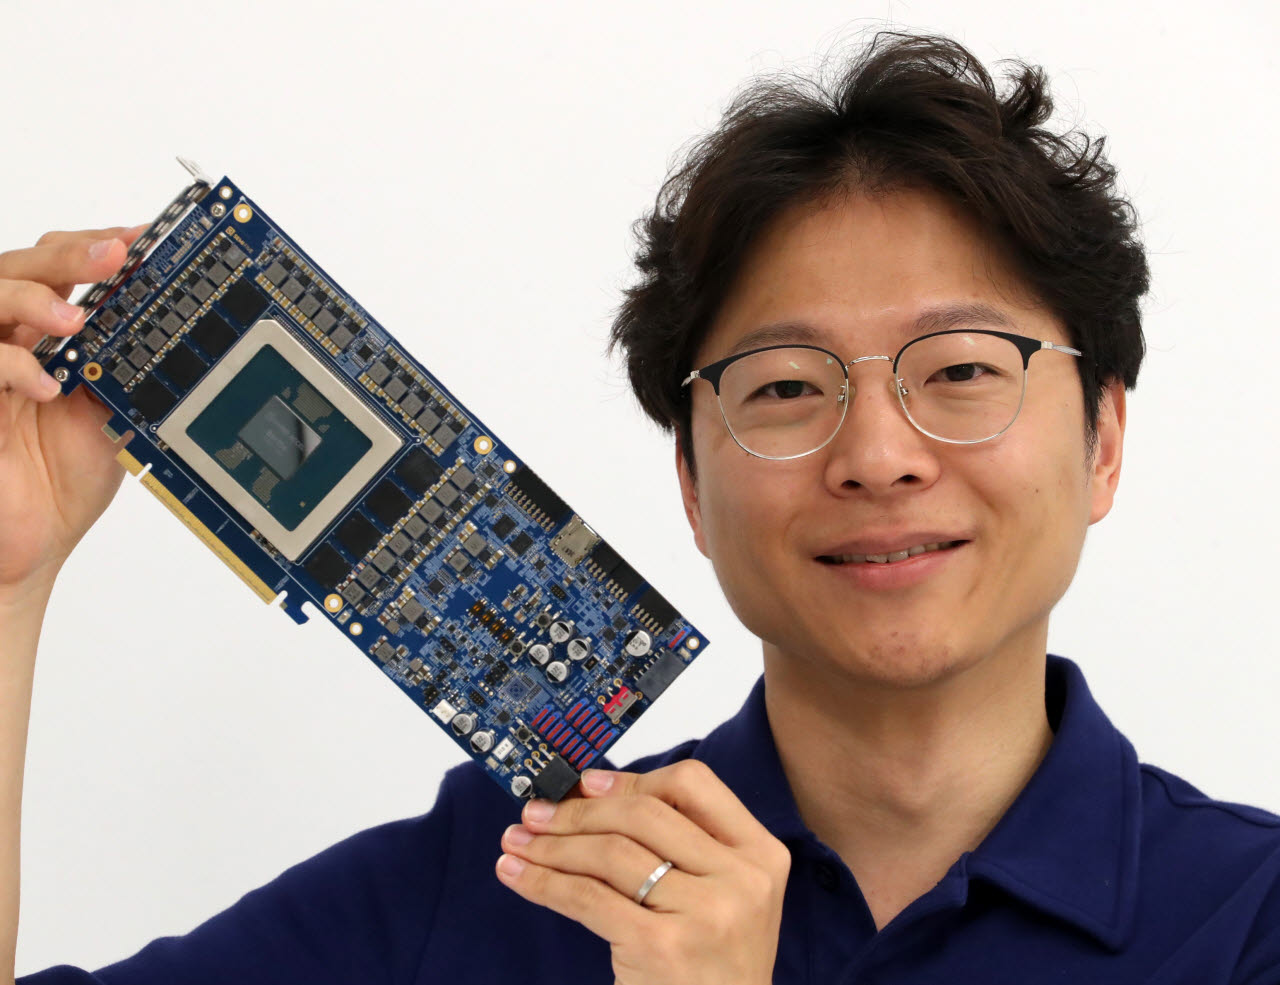
김주영 하이퍼엑셀 대표가 서버용 LPU ‘베르다(Verda)’를 들고 있다. [이데일리 김태형 기자]
AI 반도체 스타트업 하이퍼엑셀(HyperAccel)이 글로벌 경제·비즈니스 매체 포브스 아시아(Forbes Asia)가 선정한 ‘100 To Watch’에 이름을 올렸다. 사진=하이퍼엑셀
메모리에서도 기존 공식을 깼다.
AI 가속기 시장에서는 높은 메모리 대역폭을 확보하기 위해 HBM을 사용하는 것이 일반적이다. 하이퍼엑셀은 이와 달리 스마트폰 등에 사용되는 LPDDR을 선택했다.
LPDDR은 HBM보다 대역폭은 낮지만 상대적으로 저렴하고 전력 소모가 적으며 용량을 확보하기 쉽다는 장점이 있다. 하이퍼엑셀은 대신 칩 아키텍처를 통해 LPDDR의 한계를 보완하는 방식을 택했다.
김주영 대표는 “어차피 HBM을 써서는 자본과 수급 규모에서 엔비디아와 경쟁할 수 없다는 현실적인 판단도 있었다”며 “LPDDR은 HBM보다 용량이 크고 전력을 적게 먹으며 가격도 매우 저렴하지만 속도가 느리다는 약점이 있다”고 말했다.
이어 “우리는 LPU 아키텍처를 통해 LPDDR이 가진 대역폭을 최대한 활용해 90% 수준까지 끌어올리고, 서비스에 필요한 초당 30~40토큰 이상의 처리 속도를 확보했다”고 설명했다.
서버용 LPU 베르다는 500㎟ 이상의 대형 다이에 LPDDR 8개를 결합하는 구조다.
김 대표는 “미국 퀄컴이나 실리콘밸리 스타트업 포지트론 AI(Positron AI) 등도 LPDDR 기반 서버 서비스를 준비 중이지만, 실제 칩을 설계해 상용 제품화 단계까지 도달한 것은 세계에서 하이퍼엑셀이 처음”이라며 “절대적인 피크 성능보다 같은 비용과 전력으로 실제 서비스에서 얼마나 많은 토큰을 만들어낼 수 있는지가 중요하다. 달러당, 와트당 효율로 경쟁하겠다”고 말했다.
◇엔비디아와 정면승부 대신 ‘이종 결합’
하이퍼엑셀이 그리고 있는 데이터센터는 GPU를 LPU로 전면 대체하는 방식이 아니다. 서로 다른 특성을 가진 가속기를 조합하는 이종 컴퓨팅에 가깝다.
LLM 추론은 크게 입력된 문맥을 처리하는 ‘프리필(Prefill)’과 답변을 한 토큰씩 생성하는 ‘디코드(Decode)’로 나뉜다. 두 단계가 요구하는 컴퓨팅 자원이 다르다는 점을 활용하겠다는 것이다.
김 대표는 “프리필은 가성비를 앞세운 하이퍼엑셀 LPU에 맡기고, 디코드는 기존 GPU가 담당하는 식으로 서로 잘하는 일을 나눌 수 있다”며 “예를 들어 LPU와 GPU를 4대 1 같은 비율로 구성하면 전체 시스템의 비용과 전력 효율을 높일 수 있다”고 말했다.
“특성이 똑같은 칩 2개를 합쳐봐야 그 나물에 그 밥입니다. 서로 상호보완적인 GPU와 LPU를 묶으면 시너지가 날 수 있습니다.”
주요 타깃은 수십MW급 초대형 하이퍼스케일러보다는 10MW 이하 규모의 기업용 데이터센터와 코로케이션 시장이다. 자체적으로 AI 인프라를 구축하려는 기업들이 성능뿐 아니라 전력과 운영비까지 고려해야 하는 만큼 LPU의 가격 경쟁력이 통할 수 있다고 보는 것이다.
김주영 하이퍼엑셀 대표. [이데일리 김태형 기자]
사업도 대기업 수요처와 함께 검증하는 방식으로 진행하고 있다.
서버용 베르다는 기획 단계부터 협력해 온 네이버클라우드와 파일럿 형태의 개념검증(PoC)을 진행 중이다. 특정 AI 작업에서 기존 GPU 대비 실제 비용을 얼마나 낮출 수 있는지를 검증하는 것이 핵심이다.
온디바이스 AI 분야에서는 LG전자와 협력하고 있다. 베르다보다 약 10분의 1 크기로 줄인 가전용 LPU를 개발하고 있으며, 최근 설계를 마치고 파운드리에 도면을 넘기는 테이프아웃(Tape-out) 단계에 들어갔다. 공정을 거쳐 내년 1월 실물 칩을 확보할 예정이다.
산업통상부의 K-온디바이스 AI 과제를 통해 현대자동차 컨소시엄의 차량용 온디바이스 AI 반도체 개발에도 참여하고 있다.
개별 칩 공급을 넘어 시스템 단위로 사업 영역을 넓히는 작업도 진행 중이다. 복수의 서버와 가속기를 묶은 ‘랙 스케일(Rack-scale)’ 시스템을 구축해 올 연말 국가 실증 사업에 1개 랙을 공급할 예정이다.
소프트웨어도 상용화의 관건이다. 김 대표는 “LLM 서비스 환경으로 오면서 엔비디아 쿠다(CUDA)의 독점적 해자는 상당 부분 약해졌다”며 “LLM 서비스 쪽은 vLLM 같은 오픈소스 프레임워크가 주류가 됐고, 하이퍼엑셀 칩 역시 파이토치(PyTorch)와 vLLM 레벨에서 완벽히 연동되도록 설계됐다”고 말했다. 이어 “현재 회사 전체 인력 중 소프트웨어 인력이 하드웨어 인력보다 더 많다”고 덧붙였다.
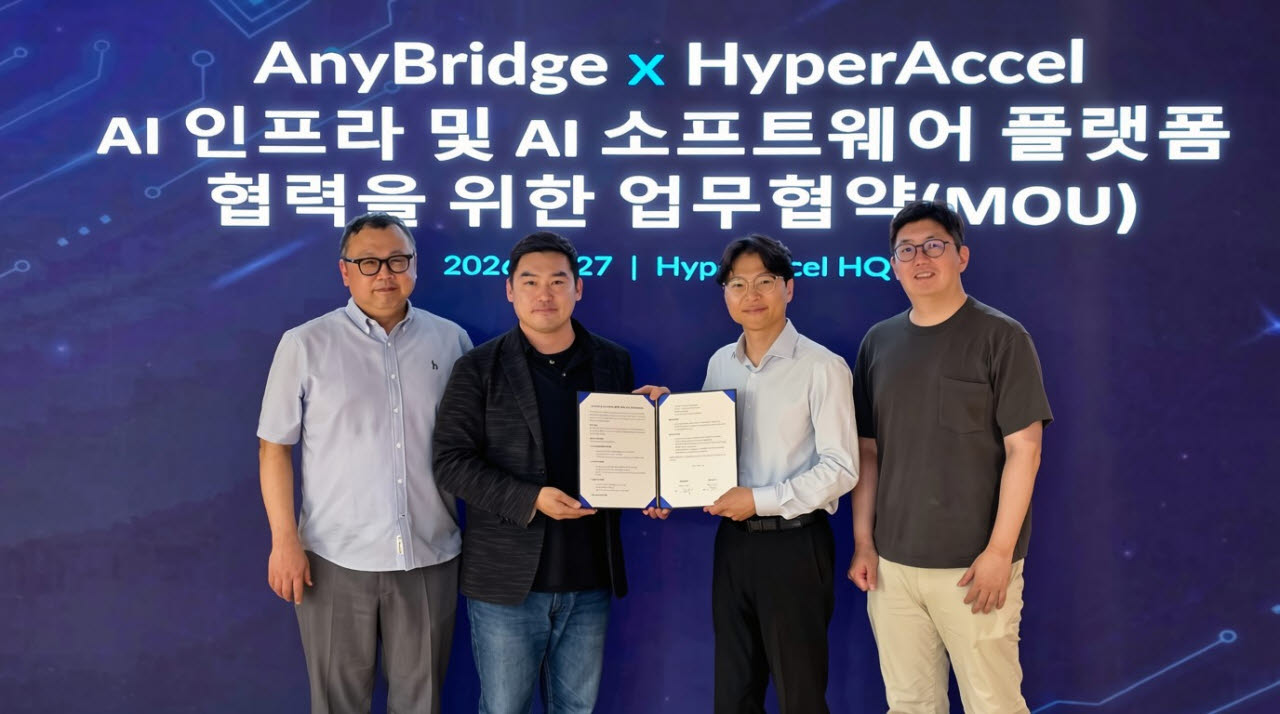
AI 반도체 스타트업 하이퍼엑셀이 AI 인프라 소프트웨어 기업 애니브릿지와 손잡고 AI 반도체부터 소프트웨어, 시스템에 이르는 ‘AI 인프라 풀스택’ 기술 개발에 나선다. 사진=하이퍼엑셀
김 대표는 KAIST 유회준 교수 연구실에서 저전력 반도체 설계를 연구하며 박사학위를 받았다. 리벨리온 오진욱 CTO와 같은 연구실에서 연구했고, 모빌린트 신동주 대표와도 대학원 시절 인연을 맺었다.
이후 미국 마이크로소프트(MS) 본사에서 8~9년가량 근무하며 데이터센터용 가속기 개발에 참여했다. 프로그래밍 가능 반도체(FPGA) 기반 데이터센터 가속기를 세계 최초로 개발하면서 하드웨어와 소프트웨어를 함께 설계하는 경험을 쌓았다. 2019년 KAIST 교수로 부임한 뒤에는 거대 모델의 하드웨어 가속 가능성을 연구했다.
창업의 계기는 2022년 글로벌 반도체 학회 ‘핫칩스(Hot Chips)’에서 트랜스포머 가속기 원천기술 프로토타입을 발표하면서 찾아왔다.
김 대표는 “당시 AMD에서 먼저 관심을 보였고, 트랜스포머 전 과정을 처음부터 끝까지 다 가속하는 시스템은 너희밖에 없으니 공동 개발하자는 제안을 받았다”며 “원천기술과 프로토타입을 확보했다는 확신을 얻고 2023년 1월 본격적으로 창업에 나섰다”고 말했다.
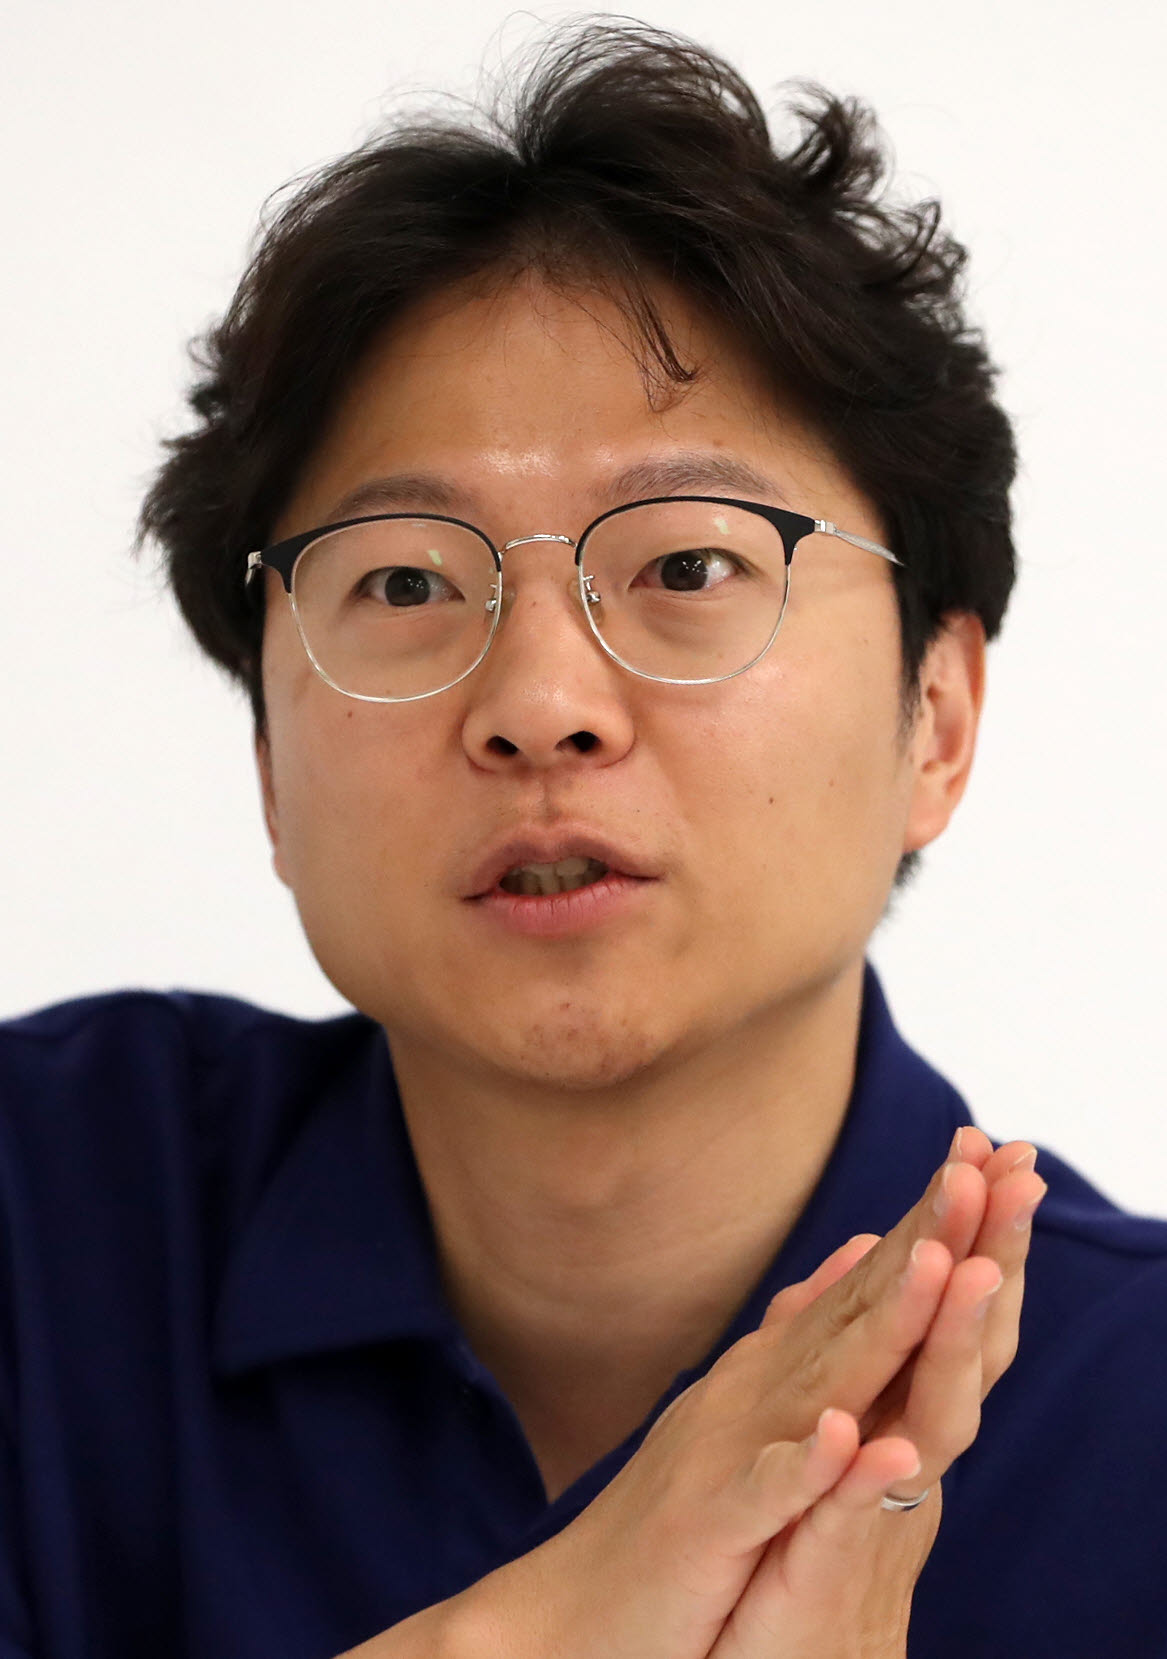
김주영 하이퍼엑셀 대표. [이데일리 김태형 기자]
하이퍼엑셀은 현재 진행 중인 시리즈B 라운드에서 1500억원 규모의 2차 클로징을 마쳤으며, 연말까지 400억~500억원을 추가 유치해 최대 2000억원으로 최종 마무리할 계획이다. 최근 국내 반도체 스타트업 최초로 ‘포브스 아시아 100대 유망기업’ 하이라이트로 선정됐다.
확보한 자금은 서버용 베르다와 LG전자 가전용 칩 양산에 투입한다. 현재 90여 명인 인력을 120~130명 수준으로 확대하는 한편, 파운드리와 패키징 업계의 공급 부족에 대비해 이미 2027년 2분기 양산 발주를 완료한 상태다.
김주영 대표는 상용화를 앞둔 AI 반도체 스타트업의 최대 과제로 ‘양산 신뢰성 확보’를 꼽았다.
“현재 엔지니어링 샘플 단계에서는 100~200장을 만들어 수백억 개 파라미터 규모의 모델들이 안정적으로 구동되는 것을 확인했습니다. 하지만 월 수천 장에서 1만 장 규모의 양산으로 넘어가려면 칩이 오랜 시간 뻗지 않고 견디는 신뢰성 테스트와 양품 선별 과정이 전자동화되어야 합니다.”
그는 AI 반도체를 한 기업의 제품을 넘어 국가 차원의 자산으로 봐야 한다고 강조했다.
“AI 반도체는 하드웨어, 소프트웨어, 패키징, 공정이 총집결된 거대한 종합예술입니다. 이를 자체적으로 해낼 수 있는 나라는 전 세계에서 미국, 중국, 한국 등 5개국 미만에 불과합니다.”
이어 “엔비디아의 최신 칩도 시장에 나와 현장에서 안정화되는 데 1년 이상 걸린다”며 “스타트업의 신생 칩이라면 초기 시행착오가 있을 수밖에 없고, 고객이 함께 써보면서 문제를 찾고 개선해 주는 의지가 필요하다”고 말했다.
“당장은 완성된 외산 GPU를 사다 쓰는 게 편리할 수 있습니다. 하지만 5년, 10년 뒤 국가적 AI 인프라 자산을 확보하려면 국내 대기업들이 상생 모델을 열어줘야 합니다. 삼성전자의 파운드리 생산 능력 배려, SK하이닉스의 메모리 공급 협력처럼 국내 대기업과 스타트업이 원팀으로 뛸 수 있는 환경이 조성되기를 바랍니다.”
하이퍼엑셀의 승부처는 칩 한 장의 최고 성능에 있지 않다. 비싼 HBM과 막대한 전력을 투입하는 기존 AI 반도체 경쟁에서 벗어나, 같은 돈과 전력으로 더 많은 토큰을 만들어내는 새로운 기준을 시장에 세울 수 있느냐가 관건이다.
엔비디아와 같은 길을 따라가기보다 자신만의 길을 택한 하이퍼엑셀이 실제 데이터센터에서 그 가능성을 증명해내길 기대한다. 이들의 도전이 국산 AI 반도체의 새로운 경쟁력을 보여주는 계기가 되기를 바란다.