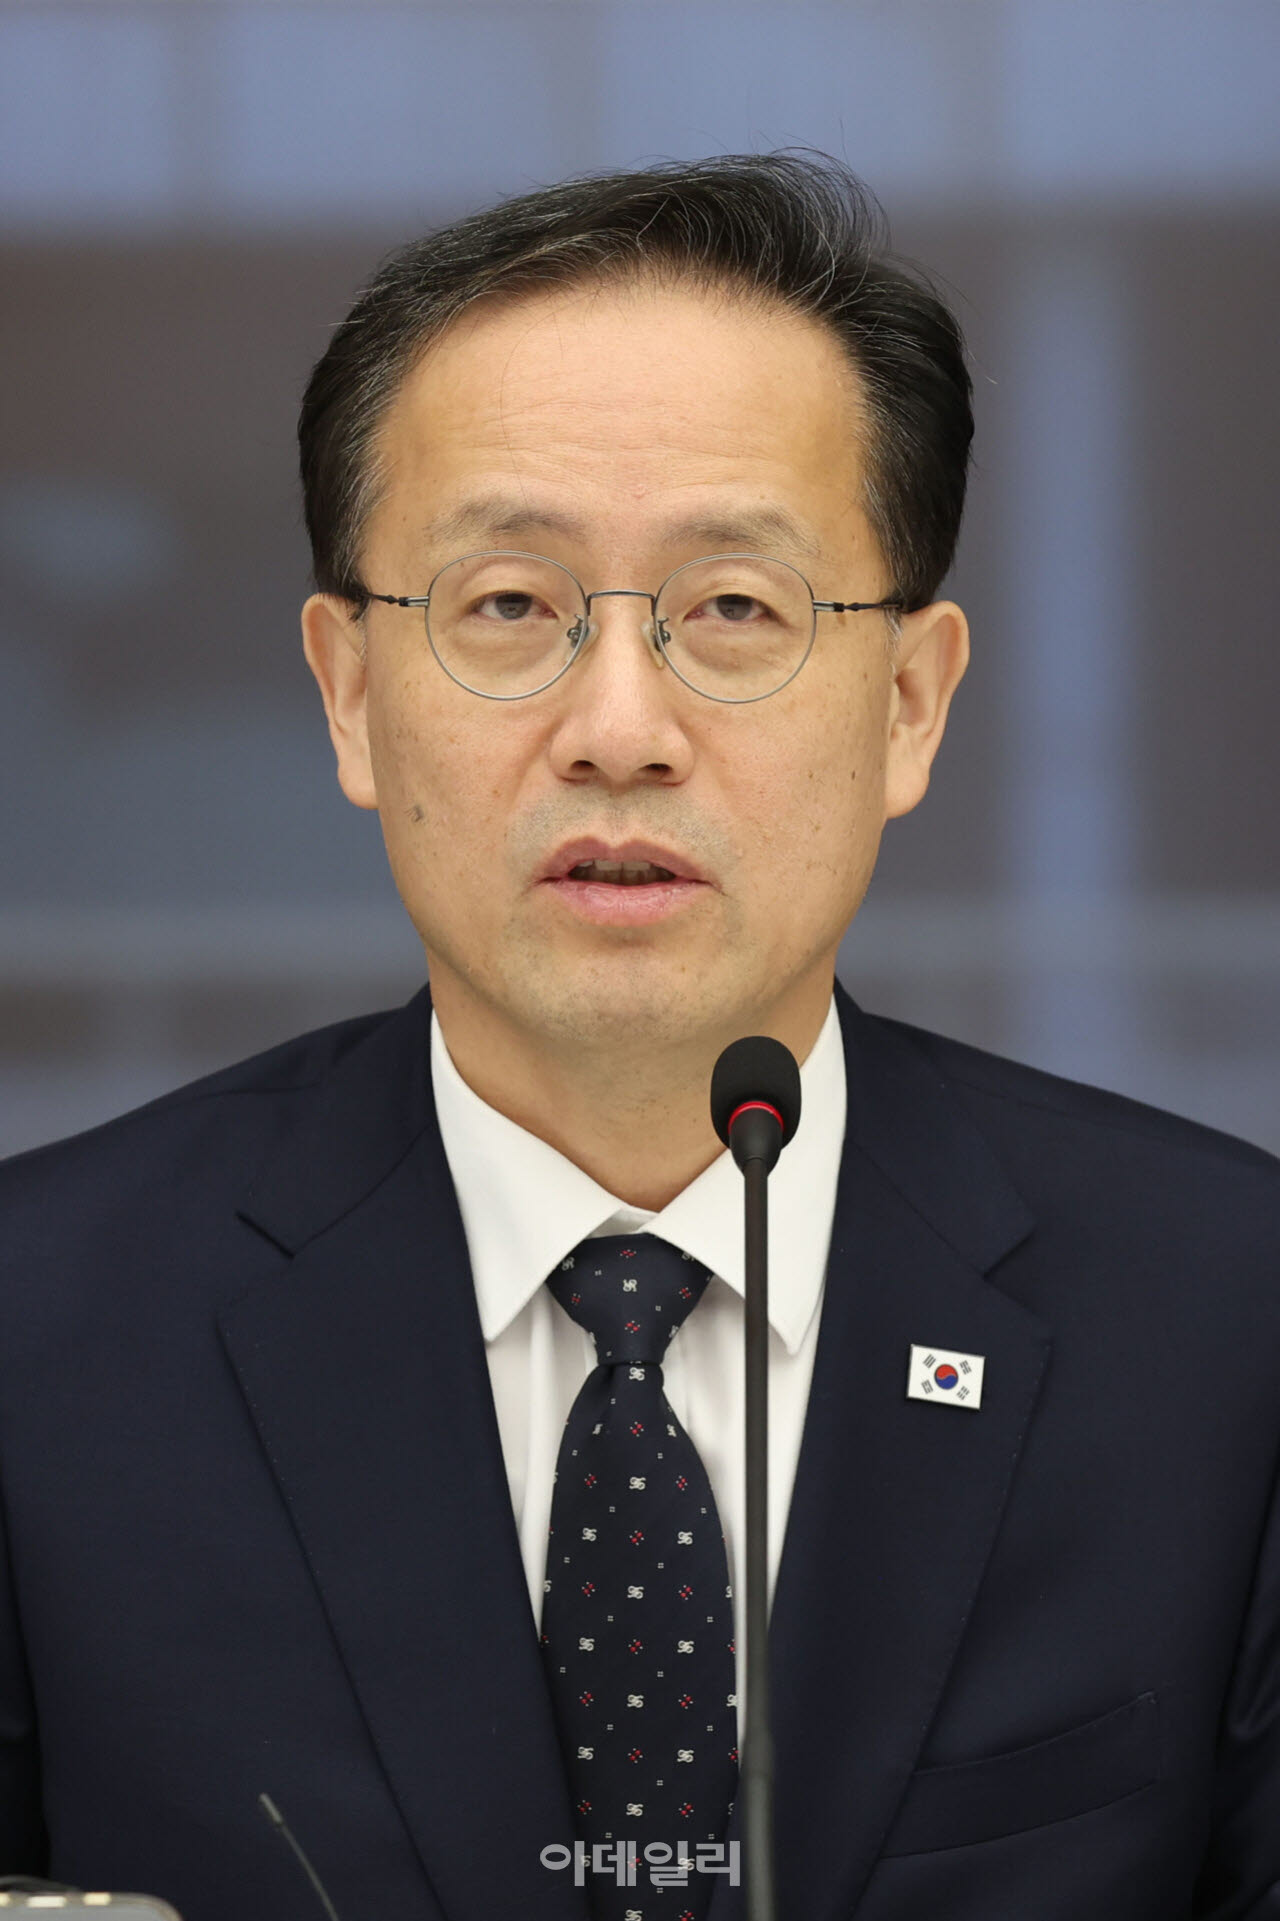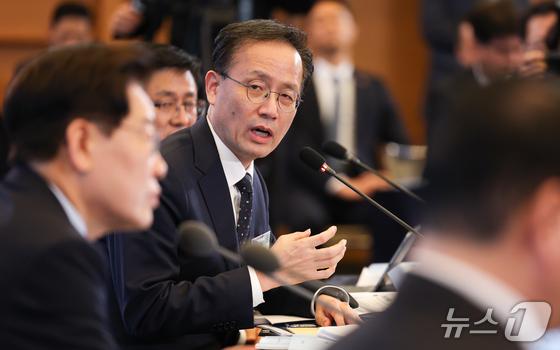
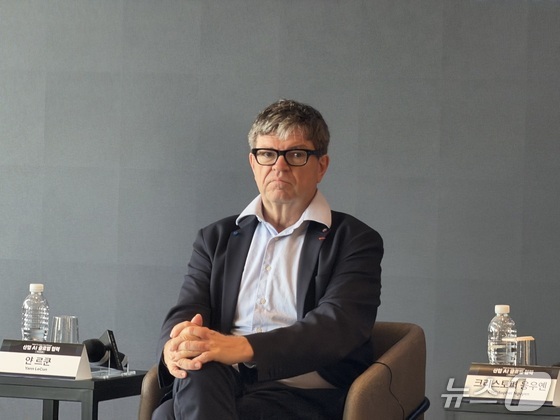
'인공지능(AI) 3대 대부'로 꼽히는 얀 르쿤 뉴욕대 교수가 12일 서울 중구 웨스틴 조선 서울에서 열린 '산업 AI 글로벌 협력' 기자간담회에서 질의응답을 진행하고 있다. 2026.10.12 © 뉴스1 이기범 기자
인공지능(AI) 석학 얀 르쿤 뉴욕대 교수가 최근 '공포감'마저 일으키고 있는 AI 해킹 문제에 대해 '기본적으로 (사람과 시스템이) 부주의 한 탓'이라고 지적했다. 또 사이버 보안에서 AI가 공격자보다 방어자에게 유리하게 작용할 것으로 봤다. 방어하는 쪽이 인력과 자금 지원에서 우위에 있다는 이유에서다.
그는 국내 금융권 연쇄 해킹과 AI를 활용한 공격 위협에 관한 질문에 최근 사이버 보안 사건들 역시 사실상 '부주의'에서 비롯된 것이지, AI를 통제할 수 없어서 생긴 문제는 아니라고 진단했다.
르쿤 교수는 12일 서울 중구 웨스틴조선서울에서 열린 '산업 AI 글로벌 협력' 기자간담회에서 이 같이 밝혔다.
르쿤 교수는 국내 금융권 해킹과 관련한 질의에 "사이버 보안과 관련해 대체로 AI가 공격자보다 방어자에게 유리하다"고 답했다. 방어하는 쪽에 더 많은 인력과 교육 수준이 높은 인재가 있고, 비밀리에 일할 필요가 없으며 자금 지원도 원활하다는 것이다.
특히 그는 개방형 커뮤니티를 통해 화이트해커들이 AI 기술을 활용하는 데 유리한 환경을 갖췄다는 점을 강조했다.
르쿤 교수는 "사이버 보안의 판도는 바뀌겠지만, 공격자에게 일방적으로 유리한 방향으로 전개되진 않을 것"이라고 낙관했다.
르쿤 교수는 앞서 'AI 종말론', '속도 조절론'에 정면으로 반박한 바 있다. 지난 9월 그는 AI를 항공기의 터보팬에 비유하며 개발 초기에는 위험할 수 있지만, 갈수록 안전해질 것이라는 주장을 폈다. 그는 2024년 5월에도 AI가 인류를 멸망시킬 것이라는 주장을 "종말론자의 망상"이라고 비판했다.
이날도 그는 "AI를 안전하게 만드는 게 터보제트 엔진을 안전하게 만드는 것보다 공학적으로 더 간단한 문제일 수 있다"고 말했다. 그는 최근 젠슨 황 엔비디아 최고경영자(CEO)가 AI를 공학적 문제로 언급한 점을 인용해 이 같은 주장을 폈다.
르쿤 교수는 현재 대규모언어모델(LLM)이 '범용 AI'(AGI)에 도달하지 못했으며, 인간의 지식을 단순 취합해 답변을 생성하는 수준에 머물러 있기 때문에 위험성이 크지 않다고 진단했다. 또 '미세 조정'(fine-tuning)을 통해 충분히 AI의 답변을 통제할 수 있다고 말했다.
AI의 안전장치를 우회하는 '탈옥' 문제와 관련해선 '목표 지향적 AI'라는 새로운 AI 시스템을 적용하면 안전장치를 벗어나기 어렵다며 청사진을 제시했다. 그가 제안한 목표 지향적 AI는 '월드모델'을 갖춰 행동에 따른 결과를 예측할 수 있는 시스템으로, 목표를 부여하면 안전장치 안에서만 업무를 수행할 수 있도록 고안됐다.
르쿤 교수는 이를 적용하면 "추론 시점에 안전장치를 반드시 준수해야 하기 때문에 시스템을 위반하는 게 불가능하다"고 말했다.
아울러 그는 인간 수준의 지능을 가진 AI 로봇이 갑자기 세상을 지배하는 것은 "공상과학(SF) 영화 속 시나리오일 뿐 현실 세계에서 혁신은 전 세계 곳곳에서 동시에 일어나 쉽게 재현될 수 있기 때문에 그런 일은 벌어지지 않는다"고 말했다.
르쿤 교수는 "변화는 매우 점진적으로 이뤄질 것이며, 인간 수준의 AI가 없던 시기와 초지능 AI가 존재하는 시기를 가르는 특정 시점이나 단일 사건은 없을 것"이라며 "수많은 기술 혁신이 이뤄지는 점진적인 발전 과정이 될 것"이라고 강조했다.
한편르쿤 교수는 제프리 힌턴 토론토대 명예교수, 요수아 벤지오 몬트리올대 교수와 함께 2018년 튜링상을 수상하며 AI 3대 대부로 평가받는다. 메타 수석 AI 과학자를 역임했으며 AI 스타트업 AMI랩스의 공동창업자 겸 회장을 맡고 있다.
Ktiger@news1.kr