카카오는 임베딩 모델 ‘Kanana-2-embedding’ 2종을 오픈소스 플랫폼 허깅페이스에 공개했다고 밝혔다. 공개 모델은 30억개(3B)와 13억개(1.3B) 파라미터 규모다.
임베딩 모델은 문장이나 문서의 의미를 숫자로 표현해 관련 정보를 찾도록 돕는 기술이다. 검색어와 문서에 같은 단어가 없어도 의미가 비슷하면 관련 정보를 찾아낼 수 있다. 기업 내부 문서 검색이나 이용자별 맥락을 이해하는 AI 에이전트의 기반 기술로 쓰인다.
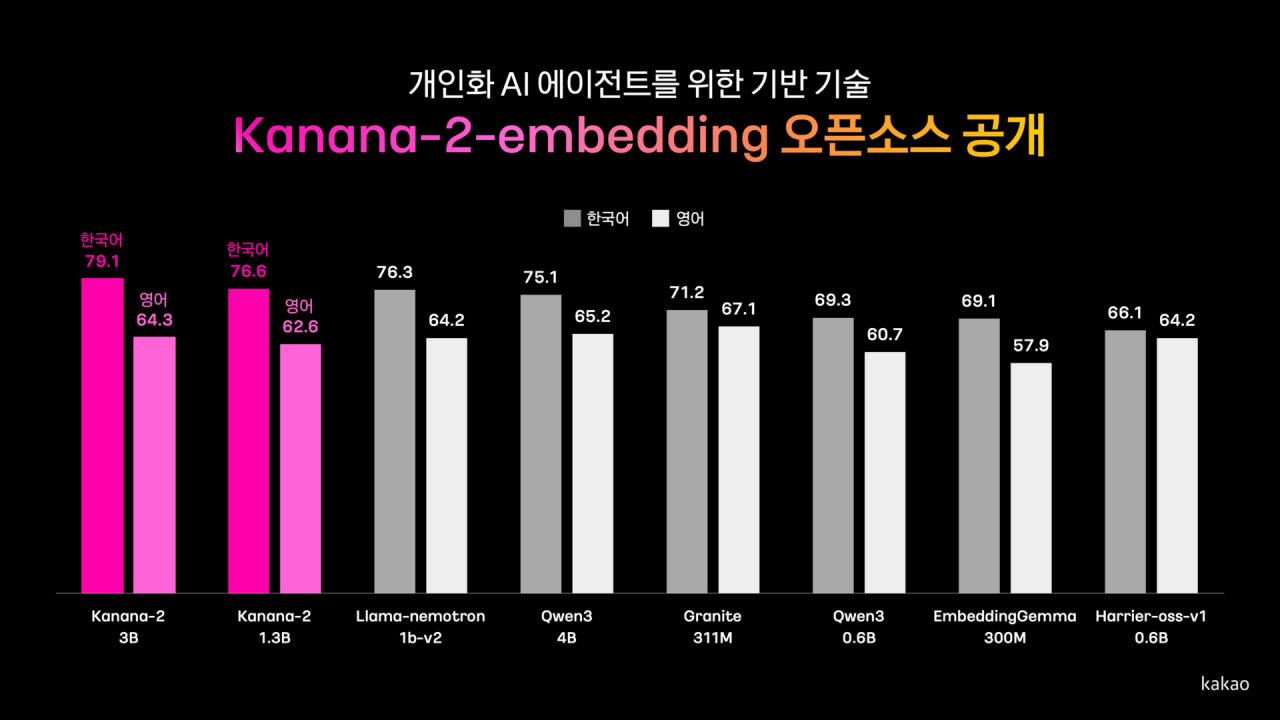
비교 모델에는 엔비디아의 ‘Llama-nemotron-embed-1b-v2’와 알리바바의 ‘Qwen3-Embedding-4B’ 등이 포함됐다. 영어 성능도 비교 모델과 대등한 수준을 보였다고 카카오는 설명했다.
검색 비용을 줄이는 기술도 적용했다. 마트료시카 표현 학습(MRL) 기법을 도입해 임베딩 벡터의 차원을 1024·512·256·128개로 조정할 수 있도록 했다. 벡터 차원이 작아지면 검색 정보를 저장하는 데 필요한 공간과 처리 부담이 줄어든다. 개발자는 서비스에 필요한 검색 성능과 비용에 맞춰 벡터 크기를 선택할 수 있다.
공개 모델에는 카카오 자체 라이선스인 ‘카나나 오픈 라이선스’가 적용됐다. 라이선스 조건을 충족하면 상업적 활용도 가능하다. 기업과 개발자는 이를 활용해 검색 시스템이나 AI 에이전트를 개발할 수 있다.
카카오 노병석 유니파이드 파운데이션 모델 성과리더. 사진=이데일리 방인권 기자