울산과학기술원(UNIST) 이연창 교수(좌측)와 박동욱 연구원. (사진=율산과학기술원)
울산과학기술원(UNIST)은 인공지능대학원 이연창 교수팀이 대형언어모델(LLM) 기반 추천 시스템의 편향과 오류를 추적하는 진단 도구 ‘에코트레이스(EchoTrace)’를 개발했다고 8일 밝혔다.
최근 챗GPT와 같은 LLM은 상품을 직접 추천하는 데 그치지 않고, 이용자의 취향을 추정한 가상 프로필이나 추천 AI의 학습자료를 만드는 데도 활용되고 있다. 문제는 AI가 생성한 정보에 오류가 포함될 경우 이후 추천에도 영향을 미칠 수 있다는 점이다.
연구팀은 영화·도서·가게 추천 시스템을 분석해 이러한 위험을 확인했다. LLM이 추천 목록을 직접 만드는 경우, 애초에 추천 대상에 없는 항목을 제시하는 비율은 영화 4.07%, 도서 7.40%, 가게 13.14%에 달했다. 각각 무비렌즈, 아마존 북스, 옐프 데이터를 활용한 실험 결과다.
이용자 정보를 추정하는 과정에서도 오류가 발생했다. 영화 이용 기록을 바탕으로 AI가 추정한 직업은 93.16%가 실제 데이터와 일치하지 않았다. 심지어 원래 직업 분류에 존재하지 않는 ‘영화 평론가’라는 직업까지 만들어냈다.
AI가 추천 모델의 학습자료를 생성할 때는 특정 장르나 업종에 편중되는 현상도 나타났다. 최종 추천 목록에서도 실제 이용 기록보다 인기 항목을 더 많이 추천하는 경향이 확인됐다.
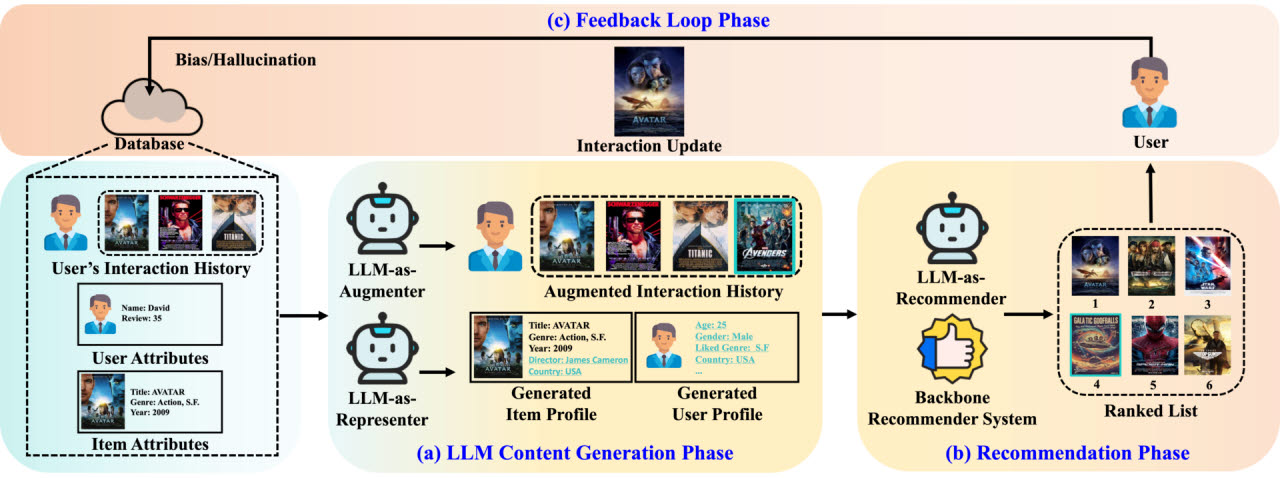
EchoTrace의 LLM 기반 추천시스템 위험 진단 과정. (a) LLM 콘텐츠 생성 단계: 사용자의 과거 상호작용(이용 기록)과 사용자·상품 정보를 바탕으로 LLM이 추가 상호작용(가상의 선택 기록)이나 사용자·상품 프로필을 생성하는 과정을 보여준다. (b) 추천 단계: 기존 추천 모델이 LLM이 생성한 정보를 활용하거나, LLM이 직접 상품을 추천해 사용자에게 최종 추천 목록을 제공하는 과정을 보여준다. (c) 피드백 루프 단계: 추천 결과에 영향을 받은 사용자의 상호작용이 다시 학습 데이터에 반영되는 과정을 보여준다. EchoTrace는 이 세 단계를 따라 LLM에서 발생한 편향과 환각이 추천 결과에 나타나고 반복적인 추천 과정에서 전파·누적되는지를 진단한다. (울산과학기술원 제공)
특히 주목할 부분은 이러한 편향과 오류가 반복 학습 과정에서도 사라지지 않았다는 점이다. 연구팀이 추천 결과를 다시 학습시키는 과정을 5차례 반복하자 일부 시스템에서는 인기 항목에 대한 쏠림이 더욱 커졌다.
LLM이 영화를 직접 추천하는 시스템에서는 이용자 100명 중 86~92명꼴로 다음 영화를 추천할 때 AI 자신이 앞서 추천했던 작품을 가장 중요한 근거로 삼았다.
이는 AI의 추천 결과가 이용자의 선택 기록으로 다시 학습되고, 이를 바탕으로 다음 추천이 이뤄지는 ‘피드백 루프’ 때문이다. 추천 시스템이 이용자의 실제 취향을 반영하기보다 자신이 만들어낸 추천 결과를 반복적으로 강화할 위험이 있다는 의미다.
연구팀은 주요 데이터마이닝·정보검색 학회에 발표된 논문 116편을 분석해 LLM의 역할을 다섯 가지로 분류했다. 이를 토대로 정보 생성과 추천 결과, 반복 학습 과정에서 오류와 편향이 어떻게 발생하고 누적되는지 점검하는 에코트레이스를 개발했다. 이번 실험에서는 이 가운데 세 가지 역할을 검증했다.
이연창 교수는 “이번 연구는 LLM 기반 추천 시스템의 편향과 환각이 반복적인 추천 과정에서 어떻게 누적되고 증폭되는지를 LLM의 역할에 따라 체계적으로 진단할 수 있는 기반을 마련했다”며 “향후 더욱 안전하고 신뢰할 수 있는 추천 시스템을 설계하고 평가하는 데 활용될 수 있을 것”이라고 밝혔다.
이번 연구는 UNIST 박동욱 연구원이 제1저자로 참여하고 미국 펜실베이니아주립대 이동원 교수와 공동 수행했다. 연구 결과는 이탈리아 로마에서 7~11일 열리는 국제학술대회 ‘ACM CIKM 2026’에 채택됐다.