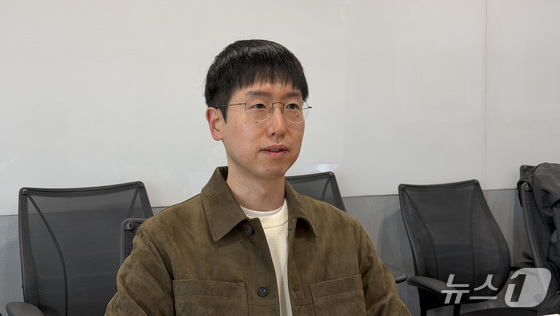
김현우 엔비디아-KAIST 공동 AI 연구소장은 10일 서울 강남구 엔비디아코리아 사무실에서 국내 취재진과 인터뷰를 진행하고 있다. 2026.11.10 © 뉴스1 이기범 기자
영어와 한국어의 인공지능(AI) 학습 데이터량은 최대 163배 차이가 납니다. 우리나라 AI 생태계에서 AI 모델이나 GPU 인프라에 비해 토양 역할을 하는 데이터는 상대적으로 덜 조명받고 있어요. 데이터는 AI에 있어 GPU만큼이나 중요합니다."
영어와 한국어의 인공지능(AI) 학습 데이터량이 최대 163배 차이 나는 가운데 엔비디아와 한국과학기술원(KAIST)이 한국어 데이터 부족 문제 해결에 나선다. 합성 데이터를 활용해 누구나 사용할 수 있는 개방형 한국어 데이터셋을 구축하고 국내 AI 생태계의 기반을 넓히겠다는 구상이다.
김현우 엔비디아·KAIST 공동 AI 연구소장은 10일 서울 강남구 엔비디아코리아 사무실에서 국내 취재진과 만나 "우리나라 AI 생태계에서 AI 모델이나 GPU 인프라에 비해 토양 역할을 하는 데이터가 상대적으로 덜 조명받았다"며 "데이터는 AI에 있어 GPU만큼이나 중요하다"고 강조했다.
지난 7월 아시아 최초로 문을 연 엔비디아·KAIST 공동 AI 연구소는 합성 데이터 기반의 개방형 우리말 데이터셋 구축을 주요 연구 과제로 추진하고 있다.
김 소장은 국내 AI 생태계에서 데이터 부족 문제 해결이 시급하다고 진단했다. 실제 구글의 대규모 다국어 학습용 데이터셋(말뭉치)인 'mC4'를 기준으로 영어와 한국어 데이터량은 약 163배 차이가 난다.
김 소장은 AI 모델을 나무, 고성능 그래픽처리장치(GPU) 등 컴퓨팅 인프라를 햇빛과 물에 비유했다. 그는 "우리 땅에 경쟁력 있는 나무들이 심어지고 본격적으로 자라기 시작했다"면서도 토양 역할을 하는 데이터는 상대적으로 주목받지 못했다고 지적했다.
김 소장은 "데이터 학습 노하우가 공개되지 않고, 각 회사들끼리 자기 내부에서만 공유하는 문제점이 있다"며 "그렇기 때문에 토양이 축적되듯 데이터가 쌓아 올려진 게 아직 없다"고 말했다.
연구소는 이 같은 격차를 줄이기 위해 AI가 생성하는 합성 데이터를 활용할 계획이다. 사람이 직접 생산하는 데이터만으로는 부족한 한국어 학습 데이터를 충분히 확보하기 어렵다는 판단에서다.
이와 함께 기존 데이터에서 더 많은 것을 학습할 수 있도록 데이터 활용 효율을 높이는 연구도 진행한다.
궁극적으로는 데이터가 지속해서 축적되고 순환하는 '데이터 플라이휠'을 구축하는 것이 목표다.
김 소장은 "우리가 개방형 우리말 데이터를 만들면 사람들은 그걸로 더 나은 모델을 만들고, 더 나은 모델이 실제 현장에서 쓰이고, 그 과정에서 새로운 데이터가 나오고, 여기서 한계와 공백이 발견되면 다시 이를 반영해 더 나은 우리말 데이터를 만들 수 있다"고 설명했다.
합성 데이터 기반의 우리말 데이터셋이 최근 불거진 저작권 문제를 완화하는 데도 도움이 될 수 있다는 취지로 설명했다.
한국어 학습 데이터에 대한 수요는 실제 현장에서도 확인되고 있다.
지난 4월 엔비디아가 한국형 AI 모델 개발을 위해 공개한 대규모 데이터셋 '네모트론 페르소나 코리아'는 AI 개발자 플랫폼 '허깅페이스'에서 열흘간 트렌딩 데이터셋 전 세계 1위에 올랐으며 다운로드 수 약 14만 회를 기록했다.
전날 공개된 LG AI연구원의 독자 AI 파운데이션 모델 'K-엑사원 2.5'에도 엔비디아의 데이터셋이 활용됐다.
엔비디아와 한국과학기술원(KAIST)의 공동 AI 연구소는 지난 7월 KAIST 김재철AI대학원에 아시아 최초로 문을 열었다. (엔비디아-KAIST 제공)
엔비디아와 KAIST의 공동 AI 연구소는 지난 7월 KAIST 김재철AI대학원에 설립됐다. 연구소는 매년 최소 10명의 KAIST 연구원에게 연구비를 지원하고, 각 연구원에게 엔비디아 인턴십 기회를 제공할 계획이다. 엔비디아는 우수한 한국인 연구원들을 정규직으로 채용할 예정이다.
아울러 5년간 총 2억 5000만 달러 상당의 컴퓨팅 인프라가 지원된다. 김 소장은 구체적인 채용 규모와 GPU 지원 수량을 밝히지는 않았지만, 연내 일부 채용 절차를 마치고 내년 하반기쯤 연구 결과물을 공개할 예정이라고 밝혔다.
KAIST 김재철AI대학원 조교수를 겸임하고 있는 김 소장은 "이번 공동 연구소는 KAIST의 뛰어난 연구 역량을 전 세계에 확인시켜 준 사례"라며 "전 세계에서 우수한 연구진들이 우리나라에 들어올 수 있게 하는 게 목표"라고 말했다.
아울러 김 소장은 최근 세계 최고 권위의 AI 학회인 'NeurIPS 2026'(뉴립스 2026)에서 KAIST가 미국 매사추세츠공대(MIT)와 스탠퍼드대를 제치고 전 세계에서 두 번째로 많은 논문이 채택된 사실을 언급하며 "우리나라의 AI 연구자들이 세계에서 이렇게 주목받고 인정받을 수 있는 것은 우리나라가 그만큼 발전했다는 증거이기도 하고, 소중한 기회를 잘 살려 AI 생태계에 씨앗을 심어 큰 숲으로 만들어 가고자 한다"고 말했다.
이어 "모두가 다 함께 우리나라 AI 생태계의 숲을 만들어 나갔으면 좋겠다"고 강조했다.
Ktiger@news1.kr