노타는 문샷AI의 ‘키미 K3.1 프로’를 최적화해 엔비디아 B300 GPU 8장이 필요했던 모델을 B200 GPU 8장에서도 실행할 수 있도록 했다고 10일 밝혔다.
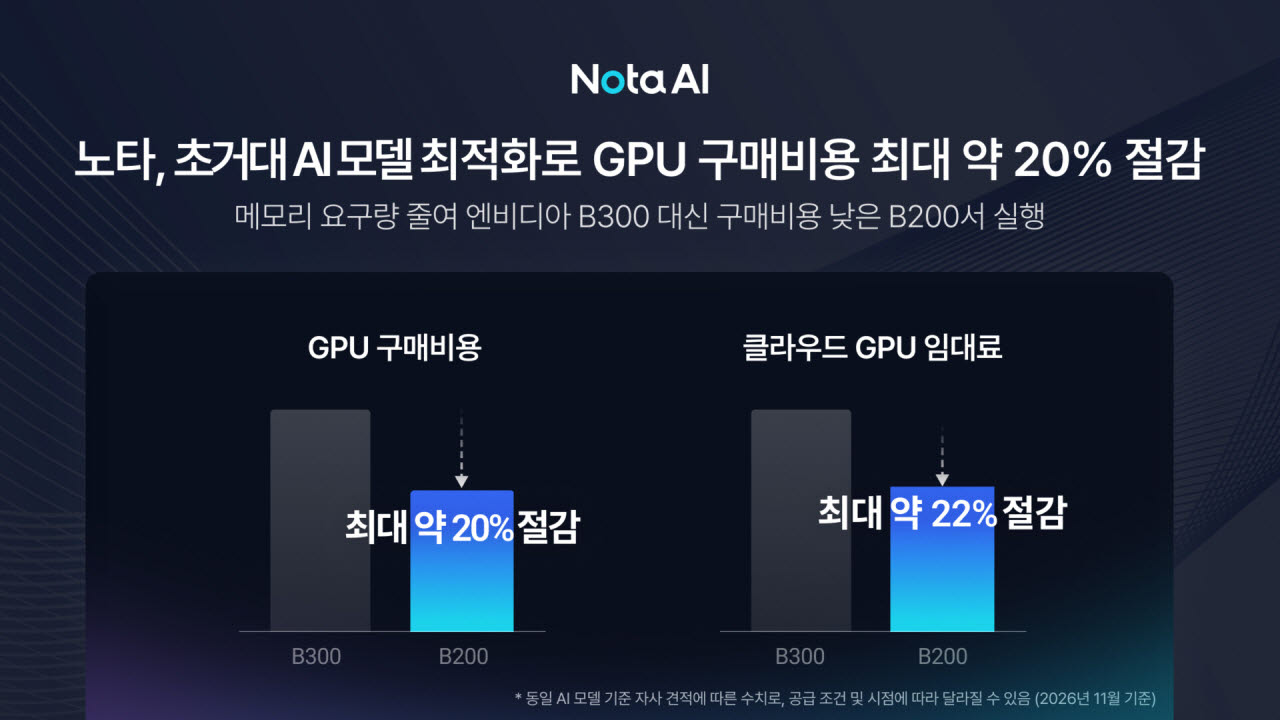
키미 K3.1 Pro 최적화 전후 GPU 비용 비교 (사진=노타)
키미 K3.1 프로는 2조8000억개의 매개변수를 갖춘 초거대 AI 모델이다. 모델 규모가 큰 만큼 실행에 필요한 메모리 용량과 GPU 확보가 주요 과제로 꼽힌다.
노타는 모델 내부의 전문가 모듈을 선별적으로 제거하는 ‘프루닝’ 기술을 적용했다. 전문가 모듈을 최대 37% 줄여 메모리 요구량을 낮추면서도, 고난도 과학 추론 평가인 ‘GPQA 다이아몬드’에서 원본 모델 점수의 99% 이상을 유지했다고 설명했다.
경량화로 확보한 메모리 여유 공간은 긴 문맥 처리에도 활용했다. B200 GPU 8장 환경에서 전문가 모듈을 30% 줄인 모델은 최대 51만2000토큰, 37% 줄인 모델은 최대 100만토큰의 문맥을 처리한다. 토큰은 AI가 글과 코드를 처리하는 단위로, 처리 가능한 문맥이 길수록 한 번에 더 많은 정보를 참고할 수 있다.
답변 생성 속도를 높이는 ‘추측 디코딩’도 지원한다. 작은 보조 모델이 다음에 나올 내용을 미리 제안하면 본 모델이 이를 한 번에 검증하는 방식이다. 노타는 줄어든 메모리 사용량을 활용해 보조 모델을 함께 실행하도록 했다.
이번 성과는 앞서 공개한 키미 K3 경량화의 후속 사례다. 노타는 당시 모델 실행에 필요한 B300 GPU를 8장에서 최대 4장으로 줄였다. 이번에는 후속 모델의 하드웨어 요구 사양을 낮춰 기업이 선택할 수 있는 GPU 구성을 넓혔다.
노타는 한정된 컴퓨팅 자원으로 고성능 AI 모델을 활용하려는 기업과 개발자를 대상으로 최적화 소프트웨어 사업을 확대할 계획이다. 경량화한 키미 K3.1 프로 모델은 AI 플랫폼 허깅페이스에 공개했다.
채명수 노타 대표는 “이번 성과는 초거대 AI 모델의 주요 추론 성능을 유지하면서 하드웨어 요구 조건을 낮춰 AI 도입의 경제성을 개선할 수 있음을 보여준다”며 “기업들이 기존 AI 인프라를 더욱 효율적으로 활용하고 새로운 모델을 합리적인 비용으로 도입할 수 있도록 최적화 소프트웨어 사업을 강화하겠다”고 말했다.